
如何构建销售招聘评分表
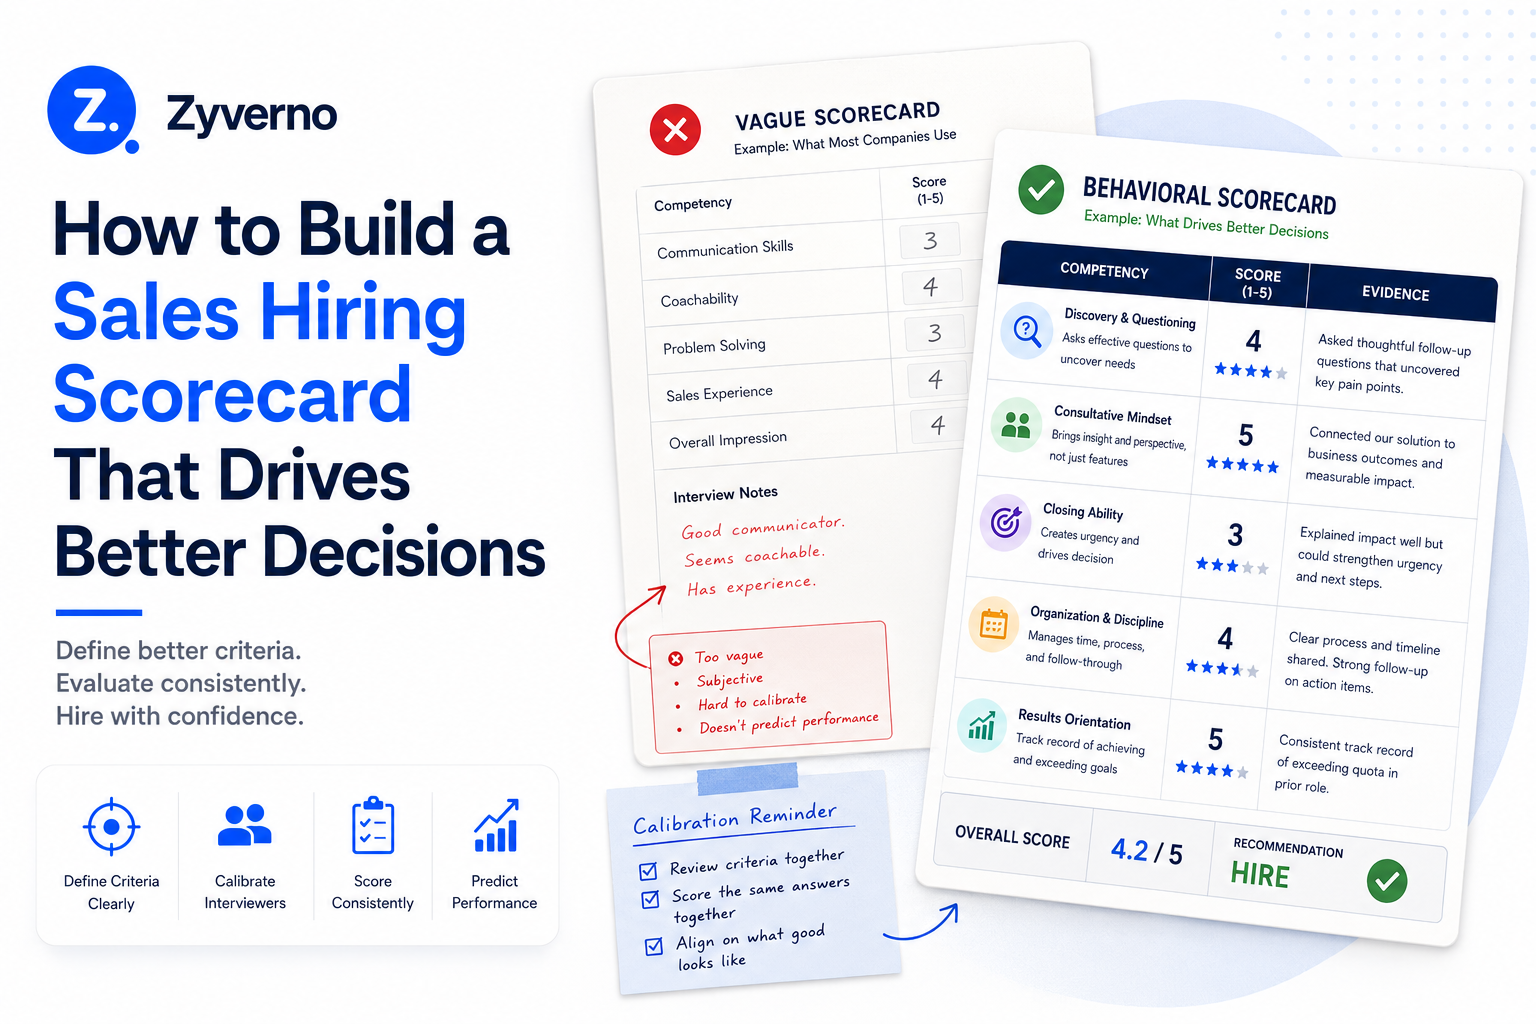
大多数销售招聘评分表是在做出决定后填写的。要构建一个实际作为决策工具的评分表:明确地定义能力,在流程开始之前校准面试官关于强与弱的标准,并将评分表的输出与明确的决策框架联系起来。以下是方法。
关键要点
- 评分表只有在面试前定义标准时才有效,而不是之后。
- 模糊标准(“沟通技巧”,“可教性”)会产生模糊、无用的评分。具有明确锚定的行为标准会产生可用数据。
- 需要校准。如果两个面试官对同一答案的评分不同,则标准不够具体。
- 评分表应该包括一个招聘建议字段和一个决策阈值:如果 X 则雇用,如果 Y 则不雇用,如果 Z 则升级。
- 追踪评分表成绩与 6 个月和 12 个月的表现。如果分数与结果无关,则标准是错误的。
大多数评分表失败的原因
在构建一个更好的评分表之前,了解什么破坏了典型的方法是有帮助的。
模糊标准。 “沟通技巧”在 1 到 5 的评分标准上对面试官而言没有任何指导意义。两个面试官可能会分别给同一个候选人打 4 分和 2 分,并且都认为他们评估的是同一件事。可观察到且具体的标准(“针对模糊回答进行了后续提问”与“接受了第一个回答并继续”)可以产生一致的评分。
Vague Criteria vs. Behavioral Criteria
The difference between a score that means something and one that does not.
没有锚定描述。 没有描述一个 3 分是什么样子、4 分与2分的区别,3 分的评分毫无意义。没有行为锚定的情况下,每位面试官都按自己的内部标准进行校准。
没有决策触发器。 大多数评分表生成一个分数后,将决策留给“评审的一致意见”。评审变成了一个辩论,拥有最强信念的人胜出,而不是最有力的证据胜出。一个不告诉你如何处理分数的评分表不是一个决策工具。
面试后填写。 当面试官在评审后而不是面试后立即完成评分表时,讨论会污染个人评估。每位面试官的分数会向集体共识偏移,从而消除了多个独立评估的好处。
根据 Sackett et al. (2022) 在应用心理学期刊 的研究,结构化面试在预测工作表现方面的平均有效性为 0.42,而非结构化面试的平均有效性为 0.16。结构不仅仅是一种管理偏好。它使得评分变得有意义。
有效销售招聘评分表的结构
第一部分:候选人和角色信息
基本背景使得评分表在几个月后复查时仍然有用:
- 候选人姓名、日期、面试官
- 正在评估的角色
- 面试阶段(招聘人员筛选、招聘经理筛选、技术评估、最终面试环节)
- 此面试官负责评估的能力
如果你的招聘人员筛选阶段使用自动预筛选工具,像 Zyverno 这样的工具会在任何人类筛选之前提供结构化的候选人数据。这些输出可以在第一阶段填充评分表的证据字段,这样招聘经理可以在审核简历时审核评分的响应,而不是一份空白表单。
在多阶段面试中,每位面试官应该负责特定的能力,而不是全部。在 45 分钟的面试中对五个维度进行评估,会使所有五个维度的评分都变得肤浅。两位面试官各自评估两个或三个维度则可以产生更深入、更可靠的评估。
第二部分:能力评分
针对该面试官评价的每个能力:
- **能力名称:**特定的(例如,“管道管理纪律”),而非通用的(“过程导向”)。
- 行为指标: 2 至 3 个可观察的行为,展示该能力高水平。
- 评分锚: 针对该特定能力的 1、3、5 分的描述。
- 证据字段: 面试官记录候选人所说或所做的具体事情,以支持该分数,而不是理由,而是实际数据。
示例能力条目:
商业敏锐性(优先级:对客户执行角色来说很高)
行为指标:
- 用财务或商业影响的术语框定客户问题,而不是功能术语。
- 在角色扮演或交易演示过程中提问商业结果。
- 能够用具体数字清晰说明以往交易的投资回报或商业案例。
评分锚:
- 5: 持续询问商业影响,量化客户术语的结果,并明确将其解决方案与可测量结果相连接。
- 3: 提出一些商业问题,但在描述价值时退回到产品语言。给出了没有量化的结果。
- 1: 用产品和功能术语描述所有交易和回应。没有询问商业影响。以技术规范语言回答“你的产品做什么?”
证据(面试官填写):_______________
分数:___/5
第三部分:具体交易演示评估
对于销售角色,交易演示是任何面试中最具信息性的部分。它有自己独立的部分:
- 描述的交易(公司类型、交易规模、周期长度):_______________
- 命名的利益相关者及其角色:_______________
- 遇到的障碍及其应对: _______________
- 具体性评分(1 到 5): 回答有多具体且详细?
- 5:命名利益相关者,回忆具体的反对意见和回应,回忆时间里程碑,以及推动交易的因素。
- 3:描述了交易类型和一般过程,但对具体时刻和利益相关者的描述较模糊。
- 1:描述了一种交易原型,而不是具体交易。被追问时无法回忆起细节。
- 一致性评分(1 到 5): 故事是否在后续问题中保持一致?
第四部分:沟通质量
每位面试官评分的独立部分,因为同事与招聘经理的评估方式不同:
- 倾听: 他们在回答前是否停顿,还是直接插嘴?是否提出澄清问题?
- 简洁性: 他们是否回答了被问的问题,还是过度解释?
- 具体性: 他们的例子是具体的还是模糊的?
- 处理不确定性: 当他们不知道某事时,他们是说不知道还是模糊其辞?
在 1 到 5 的评分基础上附上简短的证据说明。
第五部分:招聘建议
这是大多数评分表缺失的字段,缺失的原因是评分表最终成为事后理性化工具。
面试官应该进行建议,而不是作为投票,而是作为评估:
- 强烈推荐雇用: 候选人在所需水平上展示了能力。没有显著的差距。
- 雇用但存在风险: 在所需水平上展示了大多数能力。具体差距(指出)应在下一阶段中探讨或在入职期间监控。
- 需要更多信息: 由于时间或对话方向,无法评估(具体能力)。应在(下一阶段)中覆盖。
- 不雇用: 具体能力差距使得此候选人不适合该角色。
关键规则:招聘建议必须在评审之前完成,而不是之后。一旦评审开始,建议就会被锁定。评审后更改分数仅限于添加证据,而不是更改建议。
适应不同销售角色的评分表
四个核心能力(商业敏锐性、过程纪律、沟通、韧性)适用于销售角色,但权重和行为指标根据角色变化。
对于销售开发代表: 更加重视沟通和韧性。此角色需要持续的外向活动和大量的拒绝处理。管道纪律和早期潜在客户判断是相关的过程指标,而不是处理复杂性。交易演示部分转变为“冷外联演示”。
对于客户执行人员: 更加重视商业敏锐性和过程纪律。交易演示应探讨具体复杂交易。韧性很重要,但差异化信号是候选人是否从商业影响的角度进行思考,并系统管理长期管道流程。
对于销售经理: 将“商业敏锐性”替换为“辅导和发展方法”。交易演示转变为“团队发展演示”:描述一个面临困难的代表以及你做了什么。谈论他们自己的销售而不是团队发展的经理是一种可预见的失败模式。为他们描述管道评审过程添加一个特定部分。
一个用于所有三个角色的评分表会产生误导性的分数。即使结构相同,也要构建角色特定的版本。
评分表设计中的偏见保护措施
评分表通过使用行为和具体标准来减少偏见。当标准模糊时,评分表会加大偏见,面试官用主观印象填充它们。
具体保护措施:
命名行为,而非特征。 “回答前提出澄清问题”是一种行为。“似乎好奇”是一种印象。行为标准可以在候选人之间一致观察。基于特征的标准则被面试官现有的假设所过滤。
要求证据字段。 面试官必须写下候选人说的或做的具体事情,必须面对他们的分数是基于证据还是感觉。证据要求缩短了分数与理由之间的距离。
将评分与讨论分开。 面试官在评审前独立完成他们的评分和建议。集团讨论之后,个人评估会向共识偏移。将它们分开可以保留每位面试官提供的独立信号。
定期进行不利影响检查。 如果来自特定人口统计的候选人在特定能力上的评分始终较低,而没有支持这一模式的绩效数据,则标准或校准可能引入系统性偏见。每 6 到 12 个月审查候选人池的汇总数据。
校准:缺失的一步
一个有良好标准但没有校准的评分表会产生不一致的结果。校准意味着所有轮次的面试官在评估候选人之前就模糊标准的每个评分级别达成一致。
如何校准:
-
在新搜索中第一位候选人之前,进行一个校准会议(30 分钟),招聘经理描述:
- 每种能力上的 “5” 是什么样子,使用以往优秀招聘的例子或假设情境。
- “3” 是什么样子,与“好但不出色”相对应。
- “1” 是什么样子,是明显的淘汰者。
-
在前 2 至 3 次面试后,比较面试官之间的分数。如果两位面试官对同一能力分别打出了 5 分和 2 分,那么就有校准差距。在下次面试之前,进行一次简短的同步来解决这一差距。
-
对于重复角色(持续的销售开发代表或客户执行人员招聘),每季度进行校准。随着你看到真实候选人,心智模型的范围变得更精确。更新锚定以反映你所学到的内容。
随时间使用评分表数据
评分表的第二个功能,通常被忽视的是生成数据,帮助你随着时间的推移改善招聘标准。有关使用数据评估销售候选人的更广泛框架,包括哪些预聘评估与绩效最强相关,请参阅该指南。
追踪每位雇员在 6 个月和 12 个月表现与他们的预聘评分表分数之间的关系。相关性告诉你哪些标准具有预测性:
- 如果“具体交易演示”分数与 12 个月的配额达成率密切相关,则该标准是具有预测性的。赋予其更高的权重。
- 如果“沟通质量”分数与绩效没有相关性,可能是对你的角色没有预测性,或者你没有准确测量。修订或降低优先级。
- 如果标记为“在管道纪律上存在注意风险的雇佣”人员持续表现不足,则该风险标记是真实的。将其视为更严格的筛选。
这就是评分表在 12 到 18 个月使用过程中变得更好的方式。第一个版本是关于重要内容的假设。经过校准的版本是基于证据的。
有关将评分表数据与更广泛招聘指标相连接的信息,请参考销售招聘指标。对于完整的能力模型,评分表应基于 销售能力框架构建。
模板:一页销售招聘评分表
Sales Hiring Scorecard: Visual Template
Rendered version of the one-page scorecard format with behavioral anchors and decision fields
| Competency | Priority | Score (1–5) | Evidence (what they said / did) |
|---|---|---|---|
| Commercial Acumen | High |
|
Interviewer notes here |
| Process Discipline | High |
|
Interviewer notes here |
| Communication & Influence | High |
|
Interviewer notes here |
| Resilience & Self-Management | Medium |
|
Interviewer notes here |
常见问题
销售招聘评分表应该包含多少个能力?
每个面试阶段 3 到 5 个。超过五个会造成评分疲劳和浅层评估。如果你有八个重要标准,将它们分散到两个面试官之间(每人四个),而不是让一个人评估全部八个,耗时 45 分钟。
候选人是否应该看到评分表?
标准,是的。评分和建议,不应该。分享你所评估的内容可以帮助候选人准备相关示例,从而生成更好的信息。如果标准是关于实际能力而非在面试中表现的能力,这并不会给候选人带来优势。
如果面试官在评审中显著分歧怎么办?
将其视为数据。显著分数差异(在同一能力上 2 分或更多)通常意味着标准没有校准或者面试官出于候选人在每次谈话中表现的不同而看到真实的不同之处。第二种情况是有意义的:如果候选人在招聘人员面前表现良好但在招聘经理面前表现不佳,可能表明其在表面沟通方面表现良好而在领域深度方面表现欠佳。
如何为首次招聘的角色构建评分表?
从四个核心能力类别(商业敏锐性、过程纪律、沟通、韧性)开始,并根据角色的要求对其进行加权。在 5 至 8 次招聘后,查看哪些标准与绩效相关,哪些没有。第一个评分表总是一个假设。随着每次招募,精细化它。
评分表是法律要求吗?
不是。但它们通过使招聘决策可文档化并基于标准来减少法律风险。如果候选人声称歧视,文档化的评分表显示了适用的标准和候选人相对于这些标准的评分,比没有文档化的判断更具抗辩力。关键要求:标准必须与工作相关,并在同一角色的所有候选人中一致应用。